L’informaticien Leonard Kleinrock, qui a contribué de manière décisive, par sa théorie mathématique de la commutation de paquets, au développement d’ARPANET, précurseur du réseau Internet, commence son article sur l’histoire d’Internet par des noms inhabituels, que l’on n’associe que très sporadiquement, voire jamais, à ce réseau mondial. Il évoque le savant et inventeur Nikola Tesla, qui dès 1908 réfléchissait à une technologie qui « permettra à un homme d’affaires de New York de dicter des instructions qui apparaîtront instantanément sous forme imprimée dans son bureau de Londres »[1], ou encore permettra « l’accès mondial à n’importe quelle image, n’importe quel caractère, dessin ou imprimé »[2]. Si nous évoquons une « encyclopédie mondiale permanente » dans laquelle toute la mémoire humaine sera instantanément accessible à chacun ; à laquelle travaillent de nombreuses personnes à la fois ; qui est compacte dans sa forme matérielle et pourtant immense par son ampleur ; qui contient de nombreux résumés clairs de faits historiques, techniques, scientifiques, artistiques et autres ; et qui est un chemin vers la paix mondiale, nous ne pensons pas au projet Wikipédia, mais bien à une vision que l’homme de lettres H. G. Wells a consignée en 1937 dans son essai World Brain — The Idea of a Permanent World Encyclopaedia.[3] Cette encyclopédie représentait pour Wells un complément progressiste possible aux institutions traditionnelles et conservatrices que sont les universités et les écoles. Elle devait être un « organe mondial » reliant tous les esprits humains. Il est incroyable de voir comment cette vision de 1937, à l’exception peut-être de cette paix mondiale, s’est accomplie et matérialisée d’abord dans le réseau Internet, puis dans la plateforme du Web et enfin dans la Wikipédia déjà mentionnée. Là où, vue d’aujourd’hui, la prophétie de Wells tâtonne, c’est dans la manière dont il a imaginé la recherche dans ce cerveau mondial. Dans son essai, il se contente de mentionner que les informations seraient classées au moyen d’index. Il laisse ainsi au lecteur le soin d’imaginer comment fonctionneraient la navigation entre les informations et leur mise en relation. Nous savons que le cerveau humain fonctionne selon un principe associatif, c’est-à-dire qu’il n’est pas nécessaire de remonter aux étages supérieurs d’un index arborescent pour passer à une autre information : cette information nous est directement accessible sur la base d’une association dans notre mémoire.
Vannevar Bush
L’union des opérations mentales du cerveau humain et d’une technologie d’enregistrement, de recherche et de partage de l’information se matérialise sous la forme du Memex, un appareil que l’ingénieur américain Vannevar Bush propose sur le plan théorique, après la guerre, en 1945, dans l’article aujourd’hui légendaire As We May Think. Quarante-quatre ans avant que Tim Berners-Lee ne se penche à nouveau sur la même question, Bush se demande comment il serait possible d’améliorer le travail des scientifiques, et avant tout leur accès aux informations des autres chercheurs. Si les scientifiques avaient accès à la recherche actuelle, la synthèse des informations s’opérerait sur les connaissances les plus récentes, ce qui en améliorerait du même coup la qualité et contribuerait à la construction de nouvelles informations.
Avant de présenter son projet principal — le Memex —, Bush se demande si l’enregistrement même des informations ne pourrait pas être modernisé, compte tenu du développement de la photographie à l’époque. Bush imagine une caméra que l’on porte « fixée sur le front, et pas plus grosse qu’une noix »[4]. Elle enregistre tout ce vers quoi le scientifique la dirige. Un commentaire et une comparaison avec la technologie actuelle des Google Glass s’imposent. La caméra portable de Bush, fixée au front, n’est rien d’autre que le prototype de la première technologie « wearable ».
Le Memex était un appareil électromécanique hypothétique qui reliait entre eux des documents sur microfilm. Bush l’a qualifié de supplément à la mémoire humaine, rempli de tous les enregistrements, livres et communications que l’humanité a produits. Outre l’indexation traditionnelle par noms, Bush propose l’indexation associative comme mécanisme permettant de passer de n’importe quel élément à n’importe quel autre. Le Memex ressemblait à un meuble ou à un bureau, et il était prévu que le travailleur s’y installe. Il devait avoir devant lui deux écrans sur lesquels il pouvait non seulement consulter les enregistrements, mais aussi les modifier directement à l’aide d’un « stylet » et d’une interaction avec l’écran. Nous voyons ici l’idée embryonnaire de la première interface utilisateur graphique : Bush a suggéré que par l’interaction avec l’écran de l’appareil, nous pouvons modifier l’état de la mémoire de l’ordinateur. Ajoutons bien sûr que, dans le cas du Memex, il ne s’agissait pas d’un type moderne de mémoire informatique, mais du microfilm alors en usage.
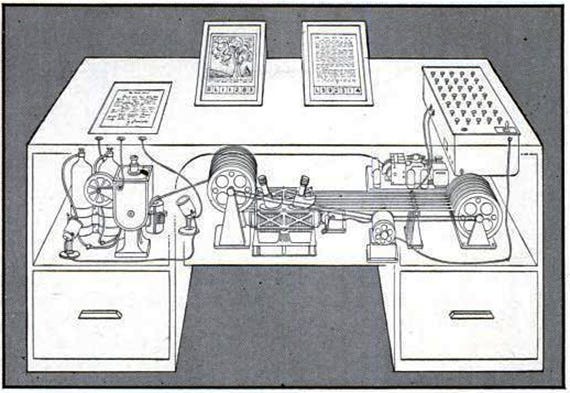
Représentation du Memex tel que Bush l’a esquissé dans son article de 1945
Source : BUSH, Vannevar. As We May Think, p. 44
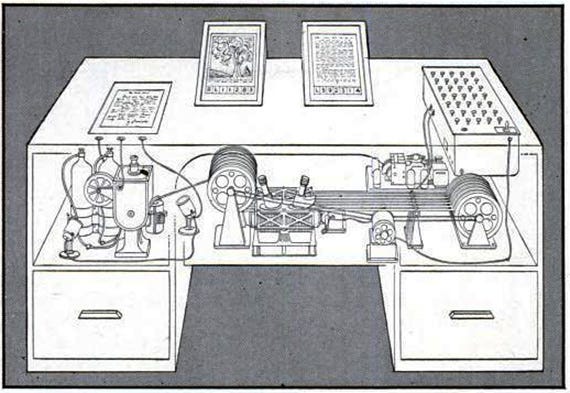
Tout le concept serait cependant dépourvu de sens si les documents ne pouvaient pas être reliés de manière raisonnable et simple. La consolidation des connaissances et la création de « pistes » propres, le long desquelles l’utilisateur avance à gué dans le déluge d’informations, sont rendues possibles par l’attribution de codes numériques aux différents documents (microfilms). Ces codes ne sont pas choisis arbitrairement, mais en fonction des pistes précédentes. Autrement dit, l’utilisateur peut créer de nouvelles pistes (qui représentent en elles-mêmes la création de récits linéaires et cohérents dans un fouillis de désordre) ou copier des pistes existantes, auxquelles il ajoute ses nouvelles notes et photographies. Rappelons que, même si les pistes qui en résultent sont de caractère linéaire, leurs différentes parties n’ont pas à dépendre les unes des autres de quelque manière que ce soit. D’où cette simulation du mécanisme associatif de la mémoire du cerveau humain.
Ces pistes constituent le fondement théorique des hyperliens ; le Memex, le premier concept d’un système hypertexte. Mais nous y trouvons davantage. Copier des pistes existantes dans son propre Memex et en modifier certaines parties rappelle un processus très bien connu dans le domaine du développement logiciel, ce qu’on appelle le forking. Si nous utilisons un système de gestion de versions lors du développement d’un logiciel, il n’est pas difficile d’implémenter une idée nouvelle susceptible de compromettre tout le travail accompli jusque-là. Il suffit de créer à partir du dépôt d’origine une nouvelle version — un fork. L’histoire du développement de logiciels open source compte de nombreux cas intéressants où un fork s’est développé en un projet entièrement nouveau et autonome. Dans le cadre du sujet de ce travail, le plus intéressant sera le fork de la société Apple, qui, à partir du projet d’origine KHTML, est devenu le moteur autonome WebKit. Le navigateur Firefox était à l’origine un fork du projet Mozilla Application Suite. Le fork le plus récent dans le domaine des navigateurs web est venu de Google qui, après avoir longtemps utilisé le moteur WebKit pour les navigateurs Chrome et Chromium, a créé un fork nommé Blink.
Bush écrit qu’« apparaîtront des formes entièrement nouvelles d’encyclopédies, nées instantanément de la réunion de pistes associatives »[5]. Il croyait aussi que naîtrait une profession consacrée précisément à l’assemblage de nouvelles pistes associatives. Même s’il ne s’agit pas aujourd’hui d’une profession à proprement parler, Bush a prédit l’activité de plusieurs milliers de bénévoles qui, chaque jour, modifient et ajoutent de nouvelles connaissances à la plus grande encyclopédie d’aujourd’hui — Wikipédia. Mentionnons enfin une idée qui ne s’est pas encore réalisée ; toutefois, au vu du développement actuel de la réalité virtuelle et du domaine qui s’occupe de la connexion et de la communication entre le cerveau et l’ordinateur — brain-computer interface —, il n’est pas exclu que d’ici quelques années les historiens de la technologie citent à nouveau le nom de Bush à propos de l’introduction des premiers systèmes offrant une connexion directe aux informations stockées. Après tout, la ligne de pensée de Bush est tout à fait logique : si toutes les perceptions sensorielles sont converties en signal électrique et que l’activité du cerveau se compose elle aussi d’activités électro(chimiques), pourquoi devons-nous d’abord convertir nos désirs et nos pensées de la forme électrique en forme mécanique (le mouvement des mains sur le clavier), pour les reconvertir ensuite en forme électrique ?
Vannevar Bush appartient sans conteste au panthéon des ingénieurs imaginatifs et originaux. Bush savait bien que ce n’était qu’une question de temps avant que les possibilités technologiques de l’époque ne rattrapent sa vision créatrice. Mais on peut aussi juger les grands penseurs d’après les successeurs que leurs idées ont influencés, et leur nombre. Chez Bush, ces noms sont véritablement grands, car il n’a influencé nul autre que Douglas Engelbart et Ted Nelson.
Brève histoire du Web — série en cinq parties :
- 1re partie : Nikola Tesla, H. G. Wells et Vannevar Bush — vous êtes en train de la lire
- 2e partie : Douglas Engelbart et NLS
- 3e partie : le Xanadu de Ted Nelson
- 4e partie : les débuts du HTML, Aspen Movie Map et HyperCard
- 5e partie : de la naissance du Web à 2007